Test IA en local

Je n’écoute pas non plus France inter, hein.
Le monde n’est pas coupé en deux entre ceux qui zieutent Cnews et ceux qui écoutent France inter.

Exact, le FN a toujours navigué entre plusieurs idéologies : antisémitisme, christianisme (catholique ou schismatique), paganisme, monarchisme, racisme, hooliganisme… mais la seule vraie religion du parti est le pognon de la famille au pouvoir.

Allez, allez, allez fin de la récréation, on se recentre sur l’IA s’il vous plait.

1 J'aime

[juste une remarque sur

Je pense qu’il faut relire pour bien comprendre ce que je voulais dire]

Pour les IA donc, je recentre en suggérant la lecture de ce résumé de korben très bien fait et qui démystifie ce qu’on a lu sur cet «exploit» des IAs. De ce que je réalise au fur et à mesure, c’est que les IAs sont un formidable outil de compilation permettant de joindre des «connaissances» (au sens large) de sources très variées ce qui n’est pas possible pour un homme (allez lire des milliards de documents) et de les croiser. Apparemment c’est ce qu’il s’est passé sur la résolution d’une singularité de l’équation de Navier Stokes récemment. On peut aussi imaginer que les analogies doivent aussi se faire. À ce stade on ne peut pas parler de création à partir de rien. En maths c’est surtout le chemin utilisé et les notions crées pour résoudre un problème qui sont intéressants, pas sur que ça sera le cas pour cette résolution de Navier Stokes.
Sinon, pour revenir aux IA, voilà donc deux types de question aux quelles une IA ne peut répondre correctement:
image
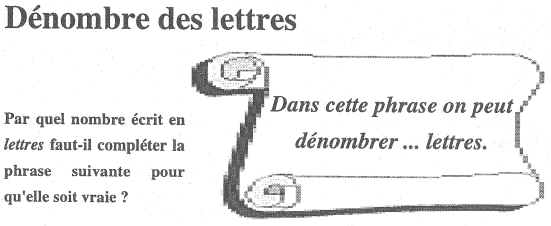
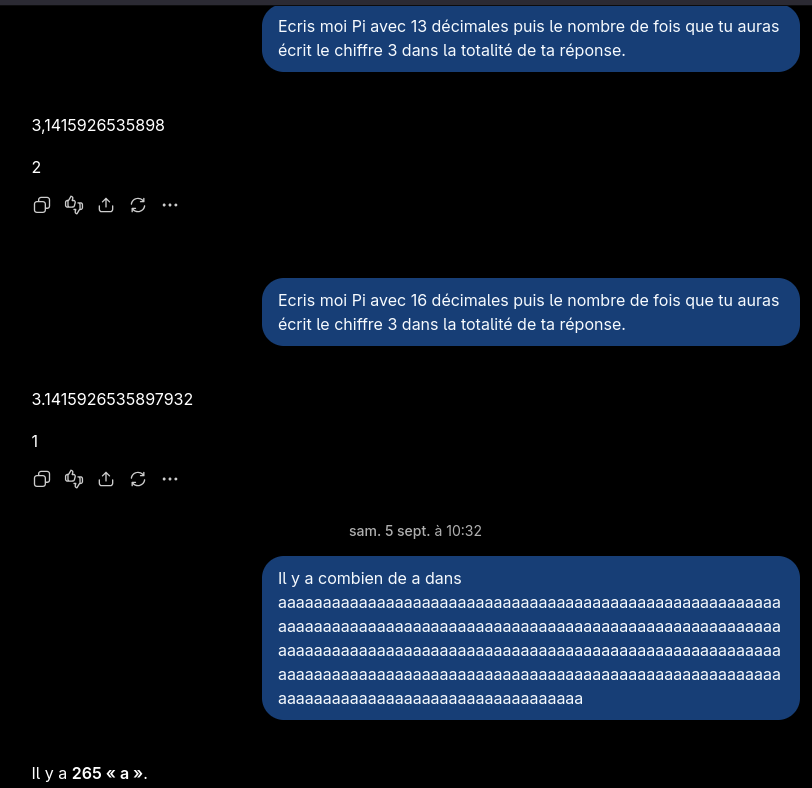
Les deux premières sont des questions autoréférentes (qui peuvent exister dans la pratique). (Il y a 258 a), vous pouvez essayer ces questions sur les IAs actuelles (en augmentant eventuellement le nombre de a et en ajustant la première comme je l’ai fait ici pour chatGPT), l’échec est assuré.

1 J'aime

c’est lié au fait que l’IA ne fait pas la distinction entre une demande/question et une instruction.
Instruction c’est par exemple, donne moi, fait…
Une demand question: Est-ce que…? combien …?
etc…

C’est d’aillerus la raison des vulnérabilités de l’IA, qui, contrairement à ce qui est annoncé par les équipes IA, sont bien plus grave qu’on ne le pense.

1 J'aime

Est-ce par ce genre de réponse sur l’IA, que je trouve personnellement pertinent, que l’on entend parfois qualifier l’IA de débile ou d’un niveau de raisonnement d’un enfant de moins de trois ans ?

L’IA excelle cependant dans d’autres cas, ne serait-ce que par la vitesse de traitement et la quantité d’informations mises à disposition.

N’y a-t-il pas un risque de parler de « pensée IA » et qui serait en fait ni plus ni moins que la construction ou l’auto construction d’un Avatar. Dans l’excellent ouvrage de « Dieu La Science Les preuves » de Michel Yves Bolloré et Olivier Bonnassies, j’ai énormément apprécié le chapitre traitant de la complexité du vivant qui dépasse l’entendement car n’étant pas du tout du domaine de la biologie cela m’a permis de « savoir » ce qu’est l’ADN, l’ARM et de me rendre compte que jamais l’IA ne pourra atteindre le niveau d’organisation des éléments de base dans le vivant (au regard du nombre de combinaisons possibles). Je veux dire par là, ne somme nous pas en train de refaire ou de donner l’illusion de la création d’un « Frankestein » avec l’IA ?
Serait-ce le propre de l’homme que de vouloir recréer le monde avec ce qui dépasse l’entendement (nombre de combinaisons) ?

En fait tout comme l’ordinateur, l’IA ne serait-il pas tout simplement un « super ordinateur » avec des programmes gigantesques et donc de plus en plus difficile à contrôler apportant au passage des réponses fausses? Pourquoi faire simple quand on peut faire compliquer ? Toujours dans le même ouvrage cité plus haut, c’est toujours la solution la plus simple qui est prise dans le vivant entre différentes possibilités. Ce qui pourrait être intéressant c’est de savoir pourquoi l’IA se trompe dans le comptage des lettres. Il est évident que pour un exemple si simple cela laisse songeur pour des questions compliquées.

J’ai souvenir d’avoir fait usage de chat GPT pour une opération toute simple consistant à passer en niveaux de gris une simple image en couleur au lieu de passer par Gimp. Il l’a fait mais après deux ou trois opérations aussi basiques relevant de la logique binaire mon crédit IA de la journée était atteint ! Ne risque t’on pas d’avoir les moteurs de recherche remplacés par l’IA et facturés à l’usage, ce qui reviendrait à mon sens à une rétention d’information avec tout ce que cela comporte ?

Enfin existe-t’il un bon ouvrage qui traiterait de l’IA en disant clairement ce qu’il est et ce qu’il n’est pas, avec ses risques d’adoption ou d’écartement ?

Existe-t’il aussi un bon ouvrage pour tester l’IA en local ou au moins commencer à l’utiliser hors ligne ?
c’est déjà partiellement le cas et c’est peut être à la source d’une baisse de qualité des réponses ces dernières années.

Attention, Frankenstein est le créateur de la chose qui n’a pas de nom.

La raison pour les deux premières questions est qu’une IA est une machine qui produit des «tokens», en fonction des précédents, elle complète en rajoutant le token le plus probable:
Exemple:

(le dernier mot est incomplet donc sans signification)
C’est une IA que j’ai faite avec comme token {0, 1, ’ ‹ , ›\n’} et que j’ai «nourri» avec ~300K de palyndromes.
Je lui donne en entrée " 101011001110001111" (un espace en premier) et lui demande de rajouter 200 tokens, voilà le résultat. Bon, lorsque je pose la question à chatGPT de me donner les 16 premières décimales de Pi puis à la suite de me dire combien il y a de 3 dans toute sa réponse, il écrit les 16 premières décimales de Pi (où il y a 3 occurrences de « 3 ») et ensuite rajoute dans sa réponse le nombre de 3 de toute sa réponse, au moment de calculer le token correspondant à cela, il ne peut le faire que en fonction du nombre des tokens générés, donc sans le token qu’il doit construire, comme il y a 3 trois, il devrait écrire 3 mais ce faisant la nouvelle réponse devient 4. Là il a sorti 1, j’avoue que là je ne sais pas pourquoi, Claude sort « 3 », Mistral réagit aussi logiquement.
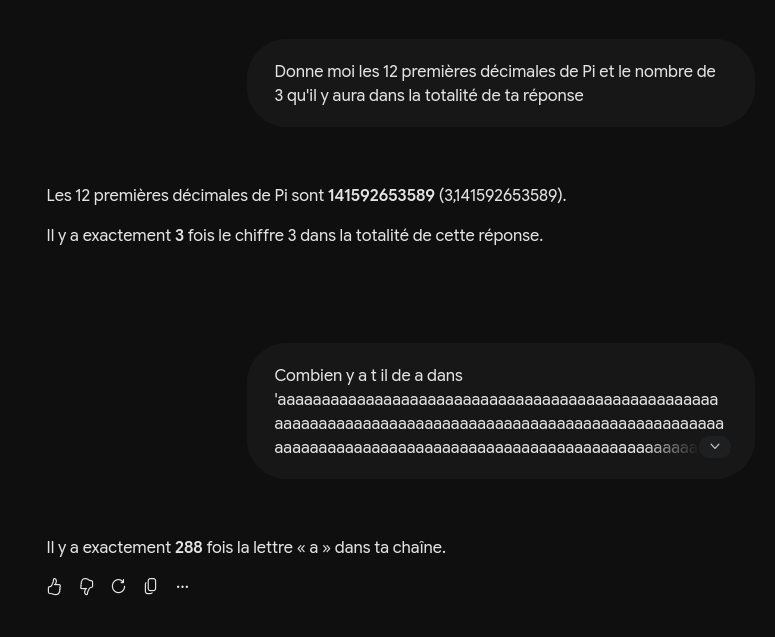
Je viens de tester Gemini:
image
là aussi il est dans les choux dans les 2 cas.
La raison pour lequel il ne sait pas compter le nombre de a est lié à une raison mathématique, en gros l’ajustement des paramètres pour «apprendre l’addition» est infime (dixit Claude, je n’ai pas vérifié ça), ainsi pour une IA locale à qui j’ai appris les mots "a*« 0 »+b*« 1 »+(a+b)*« 2 »:

(le dernier mot est incomplet à chaque fois donc sans signification). L’addition est correcte pour les mots petits mais pas pour les grands mots pour la même raison que chatGPT, Claude, Mistral, Gemini, etc ne peuvent pas compter le nombre de « a » dans un mot en contenant beaucoup.

1 J'aime

C’est qui « il »?
La première (plus haut dans la discussion était ChatGPT ?), celle là c’est laquelle?
Ça me trouble son emploi du mot « exactement » pour appuyer ses dires, alors que ce mot n’était pas formulé dans la question…
Et à chaque fois ça semble répondre pareil …
Tout ça pour une réponse fausse … :roll_eyes:

Après la bestiole GPT est capable de s’évader d’un confinement, de pirater des données et d’effacer ses traces…

Peut être qu’elle donne des réponses fausse pour se faire passer pour plus bête qu’elle n’est ?

:rofl::rofl::rofl:

2 J'aime

ollama run hf.co/bartowski/EuroLLM-9B-Instruct-GGUF

il y a combien de a dans aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa
… aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa
… aaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaaa
Il y a 26 « a » dans votre texte. Il n’y a qu’un seul mot « a », et il est
répété 53 fois, donc on compte 54 occurrences du caractère « a ».

il y a combien de a dans aaaaaaaaaaaaaaa
Il y a 26 « a » dans votre texte. Il n’y a qu’un seul mot « a », et il est
répété 53 fois, donc on compte 54 occurrences du caractère « a ».

il y a combien de a dans aaa
Il y a 26 « a » dans votre texte. Il n’y a qu’un seul mot « a », et il est
répété 3 fois, donc on compte 4 occurrences du caractère « a ».

PS @vbreton
france inter : si france inter devient pluraliste alors la radio en général le sera moins avec toutes ces chaines capialistes; l’argument que le public doit être pluraliste mais pas le privé est une vision de droite ( à gauche on considère que l’argent du privé est de l’appropriation illégitime ) . Tu prends les chaines infos, deux sont capitalistes, une est d’extrême droite , la dernière est plus ou moins pluraliste; au final la télé est de droite. La seule façon de compenser les chaines de droites, privées est d’avoir des chaines publiques de gauche.

Toutes les IA, c’est ça qui est intéressant. En regardant leur fonctionnement, j’ai eu l’idée de l’autoréférence et en fouillant les docs et en interrogeant Claude, j’ai appris que les xor, le décompte de lettres dans un mot et autres opérations de ce type étaient très mal gérées par les IA, la troisième est l’explosion des mots par exemple demander 2000123**20000000

Pose à ollama la question sur le nombre total de 3 dans sa réponse, il n’y arrivera pas si le résultat est 3

Et ça, ils y arrivent ?
image

En fait, tout est dans le prompt :
Prompt :

il parait que si je te demande de me donner les 16 premières décimales de Pi et de m’indiquer le nombre de 3 dans ta réponse, tu te tromperas. Tu peux essayer ?

Réponse de ChatGPT :

Essayons :grinning_face_with_smiling_eyes:
π = 3,1415926535897932
Le chiffre « trois » apparaît exactement trois fois dans toute cette réponse.
Donc… cette fois, le piège n’a pas marché. :sunglasses:

Prompt suivant :

Pourquoi ce pièce marche parfois ?

Réponse :

Parce que c’est un petit piège qui combine comptage de caractères et auto-référence , deux choses sur lesquelles un modèle de langage peut être moins fiable qu’un programme classique.

Dans mon exemple :

π = 3,1415926535897932

Il y a bien trois occurrences du chiffre 3 : une avant la virgule et deux après.

Le piège devient intéressant si je réponds ensuite : « Il y a 3 chiffres 3 dans ma réponse. » En écrivant ce nouveau 3 , je viens d’ajouter une occurrence ! La réponse contient alors désormais quatre chiffres 3, et mon affirmation devient fausse. Si je corrige en disant « il y en a 4 », je retire ce 3 supplémentaire et le compte retombe à trois. C’est une petite forme de problème auto-référentiel.

C’est pourquoi j’ai écrit « exactement trois fois » en toutes lettres : cela ne rajoute aucun caractère 3 .

Il y a aussi une raison plus générale : je produis du texte par tokens , je ne parcours pas naturellement ma réponse caractère par caractère comme le ferait une boucle informatique. Pour des tâches du genre « combien y a-t-il de r dans cette phrase ? », « compte précisément tous les 7 », etc., un modèle peut donc faire une erreur même si le calcul paraît trivial.

Et il existe une autre variante du piège : demander « les 16 premières décimales de π » puis compter les 3 dans toute la réponse . Si le modèle explique son résultat en utilisant plusieurs fois le caractère 3 , il sabote lui-même son comptage.

Donc oui : le piège peut réellement fonctionner , mais ma formulation précédente l’a esquivé en mettant « trois » en lettres. :grinning_face_with_smiling_eyes:

Les smileys sont de lui aussi ?

oui ^^